Le fichier llms.txt est un fichier texte déposé à la racine d’un site pour en résumer le contenu en Markdown à l’intention des agents IA. La proposition a été publiée en septembre 2024 par Jeremy Howard et sa version 2 en août 2026. Google indique qu’il n’a aucun effet sur le classement, et les logs de 137 000 domaines montrent que 97 % de ces fichiers ne sont jamais consultés. Nous avons testé 40 sites pour voir qui en publie réellement.
Qu’est-ce qu’un fichier llms.txt ?
Une page HTML est faite pour un humain. Entre le menu, les publicités, le JavaScript et les appels à l’action, l’information utile représente une petite fraction du code. Un agent qui lit la page pour répondre à une question paie le reste en jetons, et se trompe parfois en chemin.
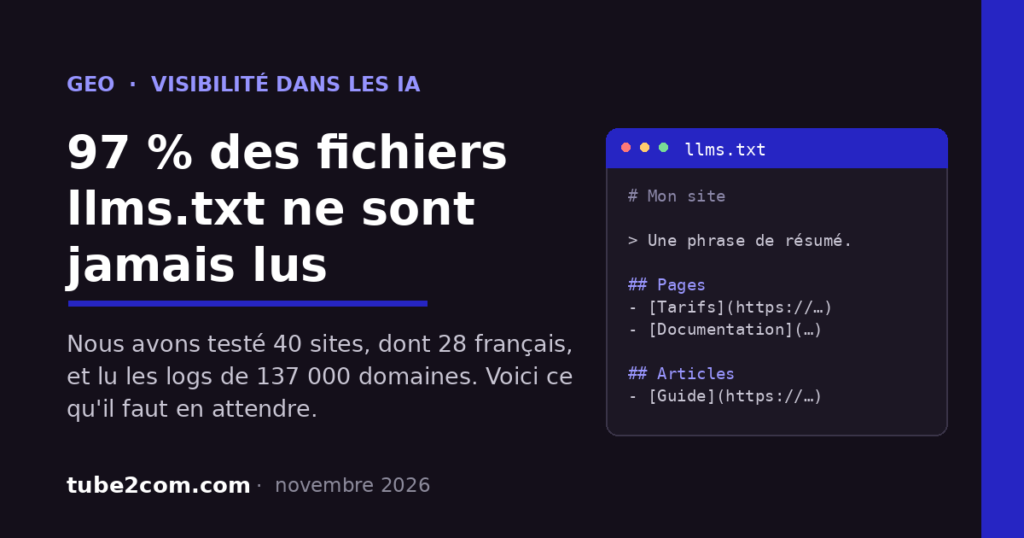
Le llms.txt propose de régler ce problème avec un fichier unique, en Markdown, qui décrit le site et pointe vers ses pages importantes :
# Nom du site

> Une phrase qui dit ce que fait l'entreprise.

## Pages
- [Tarifs](https://exemple.fr/tarifs) : les trois offres et leur prix
- [Documentation](https://exemple.fr/docs) : installation et API

## Articles
- [Guide de démarrage](https://exemple.fr/guide) : les premiers pas en 10 minutes
Trois éléments comptent : le titre, la phrase de résumé en une ligne, et des liens dont le texte explique ce qu’on trouve derrière. Le format est simple, la difficulté est ailleurs.
Google a tranché : aucun effet sur le classement
Google a mis à jour son guide d’optimisation pour la recherche IA en juin 2026 pour lever l’ambiguïté : un llms.txt n’améliore ni ne dégrade le classement dans Search, et les fichiers Markdown ne sont pas utilisés par le moteur. La position est claire et elle n’a pas changé depuis.
Il reste une bizarrerie. Chrome Lighthouse vérifie désormais la présence d’un llms.txt à la racine du domaine dans ses audits d’agents, ce qui pousse des sites à en créer un sans savoir à quoi il sert. Un audit qui recommande un fichier que le moteur ignore, voilà une bonne raison de lire les spécifications plutôt que les scores.
Ce que disent les logs : 137 000 domaines analysés
L’étude la plus solide sur le sujet date de juin 2026 : Ahrefs a analysé les logs serveur de 137 000 domaines.
- 28 % de ces domaines publient un fichier llms.txt.
- 97 % de ces fichiers n’ont reçu aucune visite en mai 2026.
- Quand un fichier est consulté, 96 % des requêtes viennent de robots, et 19,5 % seulement d’outils IA identifiés.
- 77 % des robots qui lisent ces fichiers ne sont pas des outils IA. En tête : les outils d’audit SEO, avec 21,7 % des requêtes, devant les crawlers d’entraînement (5,3 %) et les bots de récupération IA (1,1 %).
Le détail qui résume tout : Slackbot a récupéré plus de fichiers llms.txt que PerplexityBot, alors que Perplexity est précisément le moteur que ce fichier devait servir. Autrement dit, le fichier est surtout lu par des outils qui vérifient son existence, pas par des moteurs qui l’utilisent.
Notre test : 40 sites passés au crible
Les études américaines ne disent pas grand-chose du web français. Nous avons donc testé 40 domaines le 9 novembre 2026, en demandant simplement /llms.txt avec un navigateur standard, sans crawl ni outil tiers.
Résultat sur 40 domaines :
Réponse à /llms.txt |
Sites | Lecture |
|---|---|---|
Fichier servi en text/plain |
12 | llms.txt présent |
| 404 ou redirection | 17 | aucun fichier |
| 403 ou 405 | 10 | indéterminé, un pare-feu ne prouve pas l’absence |
| Page HTML au lieu du fichier | 1 | pas un llms.txt |
Sur les 28 sites français de l’échantillon, 6 exposent un fichier : seomix.fr, ctrlc.fr, premiere.page, nexus-geo.fr, abondance.com et manomano.fr. Cinq sont des agences ou des médias SEO. Un seul est un site grand public.
Parmi ceux qui répondent clairement, aucun grand média ni e-commerçant n’en publie : Le Figaro, Numerama, Cdiscount, La Redoute, Boulanger, Doctolib, Leboncoin, Back Market et Qonto répondent 404, Le Monde renvoie une page HTML à la place du fichier. Les sites qui bloquent les requêtes automatisées (Ouest-France, la Fnac, Decathlon, Sephora, Darty, BlaBlaCar, Vinted) restent indéterminés, et nous ne les comptons pas comme absents.
La conclusion est moins flatteuse que la promesse : le llms.txt est aujourd’hui un marqueur de la bulle SEO, pas une pratique du web français. Il est présent là où on parle de GEO, absent là où on fait du chiffre d’affaires.
Et chez nous ? Ce que contient le llms.txt de Tube2Com
Nous en publions un. Il est généré automatiquement par Yoast SEO, version 28.5, sans intervention de notre part.
Son contenu réel : 11 pages (accueil, contact, expertises, agences GEO et SEO), 5 articles, 5 références clients, et les témoignages, dont les liens gardent des paramètres techniques du type ?post_type=us_testimonial&p=19610.
Notre lecture : ce fichier décrit correctement l’entreprise à un agent qui cherche nos coordonnées ou nos expertises. Il ne représente pas le blog, puisqu’il ne cite que 5 articles. Nous le laissons tel quel, et nous investissons ailleurs le temps qu’il faudrait pour le tenir à jour. Un fichier exact et incomplet vaut mieux qu’un fichier complet et périmé.
llms.txt, robots.txt, ai.txt : trois fichiers, trois rôles
La confusion est fréquente, et elle coûte des décisions absurdes.
Le robots.txt reste le seul fichier reconnu par tous les acteurs. Il dit ce qu’un robot a le droit de lire, et c’est lui qui bloque GPTBot ou Google-Extended si vous le souhaitez.
Le llms.txt ne bloque rien et n’autorise rien. Il propose un résumé, il ne fixe aucune règle.
L’ai.txt relève de la même famille d’initiatives que le llms.txt : une convention proposée, sans adoption universelle. Sa portée réelle est encore plus faible.
Retenez l’ordre : le robots.txt se configure, le llms.txt se rédige, et le second ne remplace jamais le premier.
Faut-il créer un llms.txt ? Trois cas de figure
Vous publiez de la documentation produit ou technique. Créez-le. C’est le cas d’usage pour lequel la proposition a été écrite, et les agents de code lisent réellement ces fichiers. La version 2 de la spécification cite d’ailleurs les laboratoires IA qui en publient pour leurs propres docs.
Vous avez un site vitrine ou une PME locale. Vous n’en tirerez rien de mesurable aujourd’hui. Le temps est mieux placé dans des pages qui répondent à une question précise, avec des données vérifiables.
Vous gérez un catalogue e-commerce. Le fichier ne remplace pas un flux produit. Les moteurs d’achat lisent des flux structurés, pas des listes de liens Markdown.
Si vous en créez un, quatre règles suffisent
- Choisissez les pages, pas le site entier. Un agent doit pouvoir décider en trois secondes quelle page lire. Cinquante liens hiérarchisés valent mieux que quatre cents URLs.
- Écrivez une phrase par lien, après les deux points. C’est cette phrase qui sert d’argument de sélection.
- Utilisez des URLs absolues et stables. Une URL relative ou une URL à paramètres casse la lecture.
- Datez et maintenez. Un llms.txt qui cite des pages supprimées est pire que pas de fichier. Une revue par trimestre suffit.
Ce qui fait vraiment bouger les citations
Aucune donnée sérieuse ne montre aujourd’hui qu’un llms.txt augmente les citations dans ChatGPT ou Perplexity. Ce qui produit des citations est plus ancien et plus exigeant : des pages qui répondent dès le premier paragraphe, une information datée et sourcée, des entités cohérentes entre le site, la fiche Google et les annuaires, des mentions sur des sites tiers, et un balisage propre.
Autrement dit, les fondamentaux du référencement naturel appliqués à des moteurs qui synthétisent au lieu de lister. Le détail de la méthode est dans notre guide pour être référencé sur ChatGPT, et nos pages agence GEO décrivent ce que nous prenons en charge.
Le llms.txt est un ticket d’entrée à faible coût pour les sites qui ont déjà réglé le reste. Il ne remplace rien.
Ce qu’il faut retenir
Le fichier llms.txt coûte une heure et ne fait pas de mal. Il ne fait pas de bien non plus tant que les moteurs ne l’utilisent pas, et Google le dit noir sur blanc depuis juin 2026. Publiez-le si vous avez de la documentation, ignorez-le si vous avez des pages à optimiser, et ne le comptez jamais comme un levier de visibilité.
Si vous voulez savoir ce que les moteurs IA citent réellement à votre place, la réponse se mesure : nous relevons les réponses de ChatGPT et de Perplexity sur vos requêtes métier, et nous comparons avec les pages qui sont citées aujourd’hui. Vous pouvez demander ce relevé à notre équipe.